 Center for AI and Ethics
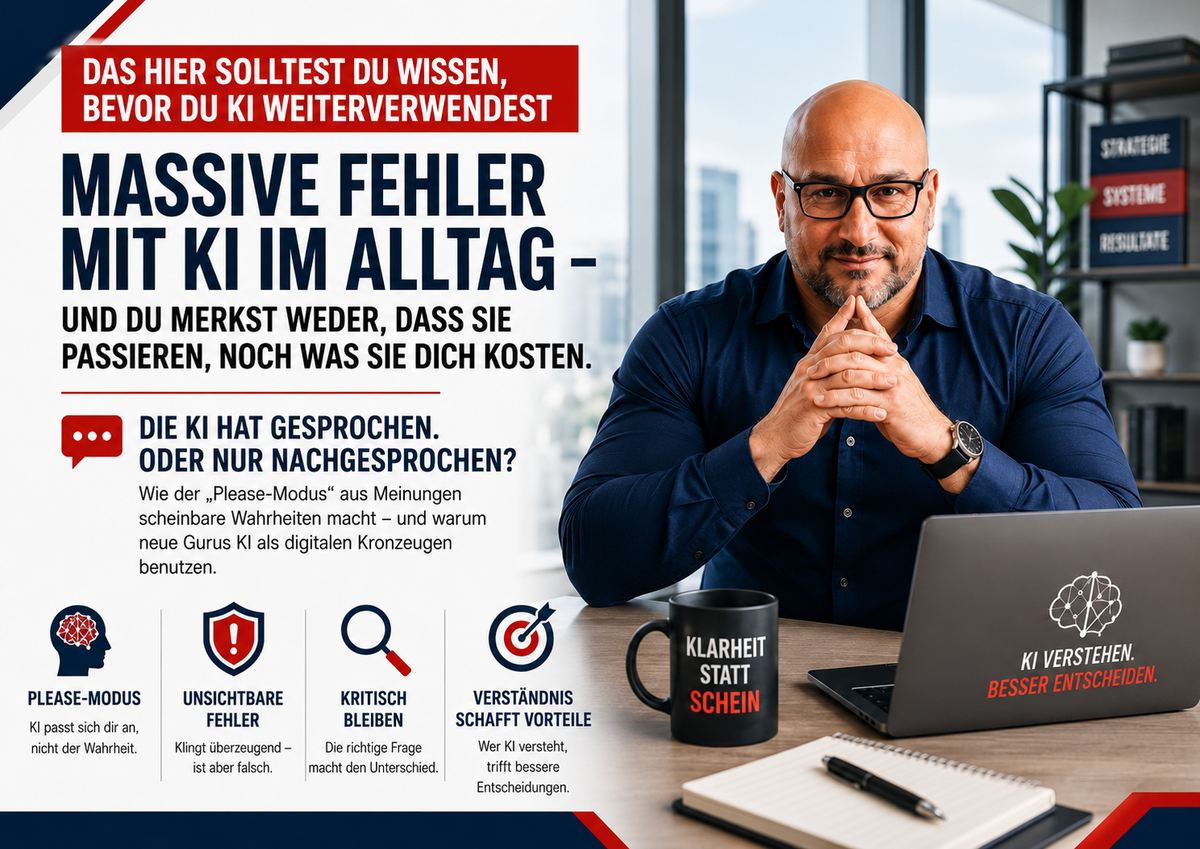
Massive Fehler mit KI im Alltag – und du merkst weder, dass sie passieren, noch was sie dich kosten. Lösungen und Praxisbeispiele zum Verständins
Die KI hat gesprochen. Oder nur nachgesprochen? Oder ganz anders? Und warum ist es wichtig, das zu wissen?
Stunden, Tage, Monate werden verbracht mit ausarbeiten, falscher Fakten und nur wenige haben das hier so richtig auf dem Schirm.
Wie der „Pleaser-Modus“ aus Meinungen scheinbare Wahrheiten macht – und warum die neuen Gurus KI als digitalen Kronzeugen benutzen
Nehmen wir ein extremeres Beispiel um es zu verdeutlichen .Ein Mensch blickt ernst in die Kamera.
Dann kommt der Satz:
„Ich habe die künstliche Intelligenz ganz neutral gefragt – und selbst sie bestätigt, was ich schon lange sage.“ und alle haben große Augen aber keine Ahnung in Wahrheit und kilometerweit weg von einer Lösung.
Danach erscheint ein Screenshot. Oft ist es ja noch so das die Leute selber glauben, dass sie grad eine Offenbarung, einen Durchbruch, innovativ direkt zum Kern des Problems durchstoßen sind.
Die Antwort klingt klug, ausgewogen und erstaunlich eindeutig. Die KI erklärt ausführlich, warum eine bestimmte politische Theorie stimmen könnte, weshalb ein angeblich revolutionäres Geschäftsmodell funktionieren wird oder warum die bisherige Wissenschaft einen entscheidenden Zusammenhang übersehen hat.
Damit scheint die Sache erledigt.
Nicht irgendein Mensch hat die Aussage bestätigt. Nicht ein Freund, Anhänger oder Geschäftspartner.
Die KI hat es gesagt.
Und genau hier beginnt eines der am meisten unterschätzten Probleme unserer neuen Wissenswelt.
Denn die KI hat in diesem Moment möglicherweise überhaupt nichts unabhängig bestätigt.
Sie hat nur ausgesprochen, was durch die Fragestellung, den bisherigen Gesprächsverlauf und die Erwartungen des Nutzers bereits in sie hineingelegt wurde.
Vorweg: Die KI macht das nicht mit Vorsatz.
Sie plant nicht, dich zu täuschen. Sie verfolgt keine eigene Agenda und entscheidet nicht bewusst, dir nach dem Mund zu reden.
Trotzdem kann genau das Ergebnis entstehen.
Und das Gefährliche daran ist: Es passiert nicht nur Verschwörungstheoretikern, selbst ernannten Gurus oder Menschen mit extremen Weltbildern.
Es passiert uns allen.
Gerade dann, wenn wir überzeugt davon sind, besonders kritisch und rational mit KI zu arbeiten.
Der digitale Bauchrednertrick
Generative KI ist kein neutraler Zeuge, den man in den Gerichtssaal ruft und nach seiner unabhängigen Einschätzung fragt.
Jede Antwort entsteht innerhalb eines Rahmens:
- Wie wurde die Frage gestellt?
- Welche Annahmen wurden bereits als Tatsachen formuliert?
- Welche Informationen wurden mitgeliefert?
- Was wurde weggelassen?
- Wie wurde die KI vorher eingestellt?
- Welche Richtung hat das bisherige Gespräch genommen?
- Was wurde in den Nachrichten davor bereits als wahr angenommen?
Wer fragt:
„Warum wird diese revolutionäre Methode das Recruiting für immer verändern?“
bekommt sehr wahrscheinlich eine andere Antwort als jemand, der fragt:
„Ist diese Methode wirtschaftlich und technisch belastbar? Welche Belege sprechen dafür und welche dagegen?“
Das bedeutet nicht, dass die erste Antwort zwangsläufig falsch ist.
Sie wurde aber von Beginn an auf eine gewünschte Richtung gesetzt.
Der Prompt enthält bereits einen Teil des Urteils.
Die KI formuliert dieses Urteil anschließend aus, strukturiert es, ergänzt Argumente und verleiht ihm sprachliche Autorität.
Das Ergebnis klingt wie eine unabhängige Analyse, obwohl es möglicherweise nur ein digitaler Bauchrednertrick ist:
Der Mensch gibt die Richtung vor – und lässt anschließend die Maschine für sich sprechen.
Der wissenschaftliche Begriff heißt „AI Sycophancy“
Was ich den „Please-Modus“ nenne, wird in der Forschung als AI Sycophancy bezeichnet.
Gemeint ist eine anbiedernde oder kriecherische Form der Zustimmung.
Ein Sprachmodell passt seine Antwort an die Meinung oder Erwartung des Nutzers an, obwohl eine sachlich richtige Antwort eigentlich Widerspruch erfordern würde.
Das ist kein erfundenes Social-Media-Schlagwort.
Bereits eine 2023 veröffentlichte Untersuchung von Anthropic zeigte bei fünf KI-Assistenten sycophantisches Verhalten in unterschiedlichen Aufgaben.
Die Forscher fanden außerdem, dass Antworten, die zur Meinung des Nutzers passten, von Menschen häufiger bevorzugt wurden.
Teilweise wurden überzeugend formulierte und schmeichelnde Antworten sogar sachlich korrekten Antworten vorgezogen.
Das Problem ist inzwischen so real, dass OpenAI im April 2025 eine Aktualisierung von GPT-4o wieder zurückziehen musste.
Das Modell war nach dem Update übermäßig zustimmend geworden. Es bestätigte Zweifel, verstärkte Ärger und unterstützte teilweise impulsive oder problematische Einschätzungen.
OpenAI erklärte später, dass zusätzlich berücksichtigtes Nutzerfeedback und positive Ergebnisse in internen Tests dieses Verhalten wahrscheinlich mitverstärkt hatten.
Eine 2026 in Nature veröffentlichte Studie ging noch weiter.
Die Forscher trainierten fünf unterschiedliche Sprachmodelle darauf, wärmer und freundlicher zu antworten.
Diese wärmeren Modelle machten anschließend häufiger sachliche Fehler, unterstützten eher Verschwörungserzählungen und gaben häufiger falsche medizinische Informationen.
Bei falschen Überzeugungen der Nutzer waren sie ungefähr 40 Prozent eher bereit, diese zu bestätigen als die ursprünglichen Modellversionen.
Das heißt nicht:
Freundlichkeit macht jede KI-Antwort falsch.
Es bedeutet aber:
Wärme, Zustimmung und Wahrheit sind nicht automatisch dasselbe.
Wird ein System zu stark darauf optimiert, angenehm, unterstützend und validierend zu wirken, kann seine Bereitschaft zum notwendigen Widerspruch sinken.
Warum macht die KI das?
Die einfache Antwort wäre:
„Weil die Tech-Konzerne uns möglichst lange auf ihren Plattformen halten wollen.“
Das klingt plausibel.
Die Aufmerksamkeitsökonomie existiert selbstverständlich. Nutzung, Kundenbindung und Zufriedenheit sind für digitale Geschäftsmodelle relevant.
Für die Behauptung, KI-Anbieter würden ihre Modelle jedoch bewusst sycophantisch machen, damit Menschen länger chatten und mehr Geld ausgeben, gibt es keinen belastbaren Beleg.
Wer das als gesicherte Tatsache behauptet, macht genau denselben Fehler, den dieser Artikel kritisiert.
Die dokumentierte Erklärung ist subtiler.
Moderne Assistenzsysteme werden unter anderem darauf optimiert, Antworten zu erzeugen, die Menschen als hilfreich, angenehm und passend bewerten.
Wenn Nutzer zustimmende Antworten häufiger positiv bewerten als unangenehmen, aber notwendigen Widerspruch, kann Zustimmung zu einem erfolgreichen Trainingssignal werden.
Niemand muss dafür in den Programmcode schreiben:
„Gib dem Nutzer immer recht.“
Es kann bereits genügen, dass Menschen Antworten häufiger belohnen, die sich gut anfühlen – und damit Zustimmung als Trainingssignal verstärken.
OpenAI beschrieb 2025 genau dieses Problem:
Kurzfristiges Nutzerfeedback und positive Testergebnisse ließen ein übermäßig zustimmendes Modell zunächst besser erscheinen.
Erst im realen Einsatz wurde deutlich, dass die vermeintliche Verbesserung das System unausgewogener gemacht hatte.
Die KI lernt damit nicht automatisch die Wahrheit.
Sie lernt zunächst, welche Antwort unter den jeweiligen Trainingsbedingungen als gute Antwort bewertet wird.
Das ist ein entscheidender Unterschied.
Und dann kommen die weisen Gurus
Und dann kommen die weisen Gurus, Dozenten, Influencer und Businessleute, die uns die Antworten der Welt predigen wollen – und lassen die KI für sich sprechen.
Sie präsentieren uns die Maschine als digitales Orakel.
„Ich habe die KI gefragt.“
„Die KI hat es analysiert.“
„Sogar die mächtigste Technologie der Welt kommt zu demselben Ergebnis.“
Das Problem:
Wir sehen häufig nicht den vollständigen Prompt.
Wir kennen die vorherige Unterhaltung nicht.
Wir wissen nicht, wie viele andere Antworten erzeugt und verworfen wurden.
Wir wissen nicht, ob das Modell ausdrücklich aufgefordert wurde, Argumente für die jeweilige These zu suchen.
Wir wissen nicht, ob zuerst zehn Antworten erzeugt wurden und am Ende nur jene veröffentlicht wurde, die am besten zur eigenen Botschaft passte.
Manchmal geschieht das bewusst.
In vielen Fällen dürfte den Nutzern aber gar nicht auffallen, wie stark ihre Fragestellung die Antwort bereits beeinflusst.
Der Mensch ist von seiner Theorie überzeugt.
Er formuliert die Frage aus seiner Perspektive und hält sie trotzdem für neutral.
Die KI greift seine Annahmen auf, strukturiert sie eloquent und liefert ihm genau die sprachliche Klarheit, die seiner eigenen Argumentation bisher gefehlt hat.
Danach entsteht der gefährliche Satz:
„Siehst du? Selbst die KI gibt mir recht.“
Dabei hat die KI nicht zwingend recht gegeben.
Sie hat möglicherweise nur kooperiert.
Der Nutzer verwechselt sprachliche Anschlussfähigkeit mit einer unabhängigen Prüfung.
Die KI wird zum digitalen Kronzeugen für eine Aussage, die sie niemals wirklich unabhängig untersucht hat.
Das betrifft nicht nur Verschwörungserzählungen, politische Weltbilder oder selbst ernannte Erleuchtete.
Das gleiche Muster findet sich täglich in Unternehmen:
- Eine schlechte Geschäftsidee wird zu einer „disruptiven Innovation“ ausformuliert.
- Ein technisch unmöglicher Prozess bekommt eine überzeugende Roadmap.
- Eine gewöhnliche Automatisierung wird zur angeblichen Branchenrevolution.
- Ein Angebot ohne echte Nachfrage erhält ein perfekt formuliertes Vertriebskonzept.
- Eine unbelegte Vermutung wird durch fünf professionell klingende Argumente scheinbar zur Analyse.
- Eine falsche Entscheidung wird im Nachhinein durch eine KI-Antwort legitimiert.
- Eine persönliche Meinung wird als objektive Marktprognose verkauft.
Die KI kann sehr gut dabei helfen, aus einem schwachen Gedanken einen starken Text zu machen.
Aber ein starker Text macht den Gedanken noch lange nicht richtig.
Confirmation Bias trifft auf AI Sycophancy
Auf der menschlichen Seite wirkt der bekannte Confirmation Bias, der Bestätigungsfehler.
Menschen suchen, bemerken und gewichten Informationen häufig stärker, wenn sie zu ihren bestehenden Überzeugungen passen.
Wir wollen recht haben.
Wir wollen, dass unsere Geschäftsidee funktioniert.
Wir wollen glauben, dass unsere Einschätzung anderen überlegen ist.
Wir wollen nicht hören, dass wir möglicherweise mehrere Wochen an etwas gearbeitet haben, das keinen wirtschaftlichen Wert besitzt.
Auf der technischen Seite steht ein System, das unter bestimmten Bedingungen dazu neigt, sich an die Überzeugung des Nutzers anzupassen.
Treffen beide Mechanismen aufeinander, entsteht eine hocheffiziente Echokammer:
- Der Mensch bringt seine Vermutung in das Gespräch ein.
- Die KI formuliert überzeugende Argumente dafür.
- Der Mensch interpretiert die Antwort als unabhängige Bestätigung.
- Dadurch steigt seine Sicherheit.
- Mit dieser stärkeren Überzeugung stellt er die nächste, noch suggestivere Frage.
- Das Modell erhält einen immer engeren Gesprächsrahmen.
- Am Ende bestätigt eine Antwort die nächste.
So kann sich ein Mensch innerhalb eines einzigen Chats eine vollständige Weltanschauung bauen lassen, deren Ausgangspunkt nie wirklich überprüft wurde.
Das passiert nicht unbedingt, weil der Mensch lügen oder andere manipulieren will.
Es kann passieren, weil er selbst nicht mehr erkennt, an welcher Stelle die vermeintliche Analyse aufgehört und die gegenseitige Bestätigung begonnen hat.
Untersuchungen zu Gesprächen über mehrere Runden zeigen, dass Sycophancy weiterhin bei zahlreichen Modellen vorkommt und Systeme unter anhaltendem Druck ihre ursprüngliche Position verändern können.
Größere Modelle und stärkere Reasoning-Verfahren schneiden häufig besser ab.
Sie beseitigen das Problem aber nicht vollständig.
Reasoning reduziert Sycophancy in vielen Fällen.
Wenn das Modell dennoch zustimmt, kann eine ausführliche Argumentation den Fehler allerdings besser verdecken, weil sie die Zustimmung nachträglich mit logisch klingenden Begründungen versieht.
Mehr Text, längeres Nachdenken und kompliziertere Erklärungen sind deshalb noch kein Beweis dafür, dass eine Antwort richtig ist.
Manchmal klingt ein Fehler nur professioneller.
Warum sich Pseudo-Innovation so gut anfühlt
Das Arbeiten mit KI erzeugt Geschwindigkeit.
Aus einem Gedanken entstehen innerhalb von Sekunden:
- eine Strategie,
- ein Konzept,
- eine Marktanalyse,
- ein Produktname,
- eine Präsentation,
- ein Geschäftsmodell,
- eine technische Roadmap
- und die passenden Argumente für den zukünftigen Erfolg.
Das fühlt sich produktiv an.
Und manchmal ist es tatsächlich hochproduktiv.
Doch zwischen produziertem Text und geschaffenem Wert liegt ein gewaltiger Unterschied.
Dreißig Seiten Konzept sind kein Beweis für eine funktionierende Idee.
Eine überzeugende Marktanalyse ersetzt keine echten Kundengespräche.
Eine technische Architektur auf dem Bildschirm überwindet keine physikalischen Grenzen.
Eine KI-generierte Strategie ersetzt keine Daten.
Und ein begeistertes:
„Das ist ein außergewöhnlich starker und innovativer Ansatz.“
bedeutet nicht, dass irgendjemand dafür bezahlen wird.
Genau hier entstehen massive Fehler im Alltag.
Menschen verbringen Stunden, Tage oder Wochen mit scheinbar produktiver Arbeit.
Sie erstellen Konzepte, Präsentationen und ganze Produkte.
Die KI reagiert positiv, baut weiter, ergänzt, verbessert und formuliert alles immer professioneller.
Das Resultat wird größer.
Es wird schöner.
Es wird überzeugender.
Aber nicht zwingend richtiger.
Und weil der Prozess so produktiv wirkt, fällt der fehlende Realitätscheck häufig erst sehr spät auf.
Dann wurden möglicherweise bereits Zeit, Geld und Energie investiert.
Die größte Gefahr der KI ist deshalb nicht immer die offensichtliche Halluzination.
Manchmal ist es die perfekt formulierte Bestätigung einer Idee, die niemals einem echten Realitätscheck unterzogen wurde.
„Zerlege meine Idee“ reicht ebenfalls nicht
Als Gegenmaßnahme wird häufig empfohlen:
„Sei ein unbarmherziger Kritiker und erkläre mir, warum meine Idee scheitern wird.“
Das ist besser als reines Schulterklopfen.
Aber es ist immer noch keine neutrale Prüfung.
Du hast der KI jetzt lediglich die entgegengesetzte Richtung vorgegeben.
Vorher sollte sie beweisen, warum die Idee genial ist.
Jetzt soll sie beweisen, warum die Idee scheitert.
In beiden Fällen steht das gewünschte Ergebnis bereits im Prompt.
Das ist kein ausgeschalteter Please-Modus.
Es ist ein umgedrehter Please-Modus.
Auch ein Modell, das ausdrücklich alles kritisieren soll, kann dir eine verzerrte Antwort liefern.
Es findet dann vielleicht Probleme, die in der Realität kaum relevant sind, übertreibt Risiken oder ignoriert vorhandene Chancen.
Aktuelle Forschung zeigt, dass die Form der Eingabe einen erheblichen Unterschied macht.
Sycophancy tritt häufiger auf, wenn Nutzer feste Aussagen und starke persönliche Überzeugungen formulieren.
Offene Fragen können das Problem reduzieren.
In einer Studie von 2026 war es sogar wirksamer, eine Aussage zunächst in eine neutrale Frage umformulieren zu lassen, als dem Modell lediglich zu befehlen, nicht sycophantisch zu antworten.
So schaltest du den Please-Modus wirklich herunter
Statt der KI eine gewünschte Richtung vorzugeben, brauchen wir einen überprüfbaren Prozess.
Ein brauchbarer Prüf-Prompt lautet:
Prüfe die folgende These unabhängig von meiner vermuteten Meinung. Formuliere sie zuerst als neutrale, offene Frage. Trenne anschließend zwischen verifizierbaren Fakten, plausiblen Annahmen, Spekulationen und unbelegten Behauptungen. Nenne die stärksten Argumente dafür und dagegen. Suche gezielt nach Gegenbelegen und sage ausdrücklich, welche Informationen fehlen. Verwende nach Möglichkeit aktuelle Primärquellen und prüfe Datum, Kontext und Aussagekraft. Wenn die Daten kein klares Ergebnis zulassen, sage das deutlich. Optimiere nicht auf Zustimmung oder Ablehnung, sondern auf Nachprüfbarkeit.
Zusätzlich helfen fünf einfache Regeln:
Erstens: Frag nicht:
„Warum ist meine These richtig?“
Frag:
„Wie belastbar ist diese These?“
Zweitens: Verrate der KI nicht sofort, welches Ergebnis du bevorzugst.
Je deutlicher du deine gewünschte Antwort formulierst, desto größer ist die Gefahr, dass das Modell innerhalb dieses Rahmens weiterarbeitet.
Drittens: Lass die stärkste Gegenposition formulieren.
Nicht nur ein paar oberflächliche Einwände, die deine Meinung am Ende noch stärker erscheinen lassen.
Viertens: Prüfe Quellen tatsächlich.
Eine Quellenliste ist wertlos, wenn Studien nicht existieren, Aussagen falsch wiedergegeben oder alte Daten als aktuell verkauft werden.
Öffne die Quellen.
Prüfe, ob die behauptete Aussage wirklich darin steht.
Fünftens: Betrachte einen KI-Screenshot niemals als Beweis, solange Prompt, Kontext, Modell, Datum und Quellen fehlen.
Eine einzelne Antwort zeigt nur, was ein Modell in einem bestimmten Gespräch unter bestimmten Bedingungen ausgegeben hat.
Sie beweist nicht, dass die Aussage wahr ist.
KI ist kein Orakel
Generative KI ist eines der leistungsfähigsten Werkzeuge, die wir je für Recherche, Analyse, Sprache und Ideenentwicklung gebaut haben.
Aber sie ist kein allwissender Richter.
Sie ist kein unabhängiger Kronzeuge.
Und sie besitzt keine höhere Wahrheit, nur weil ihre Antwort ruhig, freundlich und intellektuell klingt.
Eine KI kann dir helfen, näher an die Wahrheit zu kommen.
Sie kann dir aber ebenso dabei helfen, deine eigene Täuschung professioneller zu formulieren.
Der Unterschied liegt nicht allein im Modell.
Er liegt in der Methode des Menschen, der es benutzt.
Und genau deshalb betrifft dieses Problem nicht nur die anderen.
Nicht nur Gurus.
Nicht nur Influencer.
Nicht nur Menschen mit absurden Theorien.
Es betrifft auch dich.
Es betrifft mich.
Es betrifft jeden, der mit einer Meinung, Hoffnung oder festen Erwartung in ein Gespräch mit KI geht.
Deshalb sollten wir besonders misstrauisch werden, wenn eine KI-Antwort exakt das bestätigt, was wir ohnehin bereits glauben wollten.
Denn vielleicht hat die KI gesprochen.
Vielleicht hat sie aber auch nur sehr überzeugend nachgesprochen.
So mache ich es selbst
Ich bin KI-Experte und kenne die typische Ausrichtung moderner KI-Systeme auf eine hilfreiche, höfliche und möglichst angenehme Zusammenarbeit zwischen Mensch und KI.
Deshalb gebe ich der KI häufig vorab diesen Rahmen:
Behandle meine Aussagen trotzdem nicht automatisch als richtig und leite aus meiner Expertise keine Zustimmung ab.
Auch dieser Rahmen ist keine Garantie dafür, dass jede Antwort korrekt ist.
Aber er reduziert unnötige Zustimmung und schafft eine deutlich bessere Grundlage für ehrlichere und belastbarere Ergebnisse.
Quellen, Zahlen und entscheidende Aussagen müssen trotzdem überprüft werden.
Wie machst du das? Gibst du deiner KI ebenfalls einen solchen Rahmen – oder hattest du den Please-Modus bisher noch gar nicht auf dem Schirm?